Русский
 English
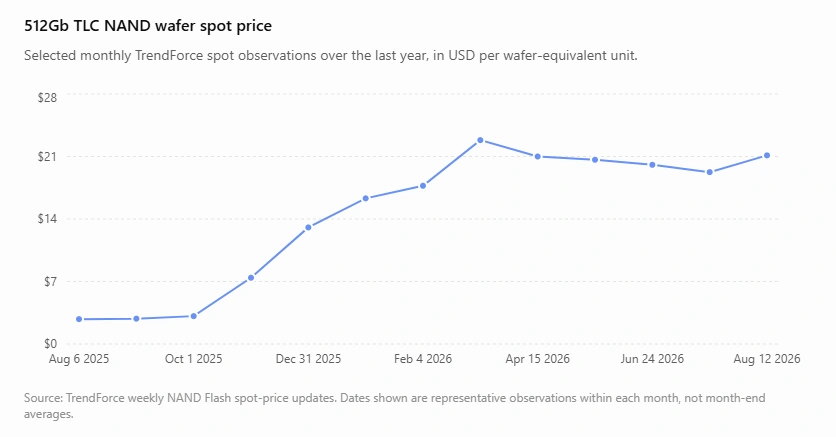
Масштабный запуск платформы NVIDIA Vera Rubin заметно влияет на рынок полупроводников: из‑за архитектуры новой системы вырос спрос на TLC NAND‑память, что привело к повышению цен. По отраслевым данным, стоимость 512 Gb TLC NAND достигла $21 — после снижения ниже этого уровня в июне.
Почему растёт спрос: роль технологии CMX
Ключевым фактором стала технология Context Memory eXtension (CMX), внедрённая в Vera Rubin. Она формирует промежуточный уровень хранения данных между высокоскоростной HBM‑памятью и традиционными системами хранения. Основное назначение CMX — обработка KV‑кэша: временных данных, создаваемых ИИ‑моделями при анализе запросов и генерации ответов.
Технические особенности CMX:
- Тип памяти. В CMX используются большие массивы TLC‑флеш‑памяти.
- Подключение. Массивы подключаются к GPU‑кластерам через ускорители NVIDIA BlueField‑4 и сеть Spectrum‑X Ethernet.
- Ёмкость. Один сервер CMX в форм‑факторе 2U способен вмещать порядка 600 ТБ флеш‑памяти; при масштабировании объём системы может достигать нескольких петабайт.
Рыночные эффекты
Помимо прямого спроса на TLC NAND, дополнительное давление на рынок создаёт растущая потребность в корпоративных SSD для дата‑центров: по мере расширения ИИ‑инфраструктуры NVIDIA и её партнёров производители памяти перераспределяют ресурсы в сторону серверного сегмента.
При этом существенная доля NAND‑памяти для проектов NVIDIA, вероятно, уже закреплена долгосрочными контрактами. Даже без учёта «открытого рынка» такой объём бронирований сокращает доступное предложение и толкает цены вверх.
Слухи и прогнозы
На фоне этих тенденций появились слухи о возможном снижении объёма HBM4E в будущих модификациях Vera Rubin Ultra из‑за ограничений поставок. Однако отраслевые аналитики склоняются к тому, что любые корректировки будут носить временный характер и не означают перехода на заведомо более слабые конфигурации.
Для индустрии кейс важен как пример того, как архитектура ИИ‑платформ напрямую влияет на цепочки поставок и цены на компоненты, которые традиционно считались «вторичными» по отношению к самим GPU.